ШІ зміщує вузьке місце, а не відповідальність
Агенти беруть на себе дедалі більше виконання, а рідкісною людською роботою стає інше: правильно поставити задачу, довести результат і вибрати те, що команда зможе підтримувати. Про це — PM Lead Pro.
Якщо ваша команда вже користується Claude чи Codex, ви, мабуть, помітили: швидше за все пишеться код, а повільніше — переконатися, що він робить саме те, що треба бізнесу. Раніше питання було «як змусити модель правильно написати наступний шматок». Тепер — «що має бути правдою, перш ніж ми довіримо весь результат». Агент щомісяця виконує більшу частину циклу. Визначити, що означає «готово», довести це і відповідати за те, що станеться після релізу, — це на агента не переїхало.
PM Lead Pro розбирає цей зсув на доказах: скільки ШІ реально коштує в роботі, де агенти ламаються і які контрольні точки перетворюють швидке демо на рішення, яке можна підтримувати.
Три сигнали, що пояснюють зсув
- Від кращих промптів до перевірених процедур. Дослідження SkillOpt від Microsoft Research (30.06.2026) розглядає файл скілу агента як те, що оптимізують малими перевіреними правками, а не пишуть один раз. Інструкція для агента стає артефактом, який тестують і підтримують. Це бенчмарк-дослідження, а не виміряне зростання продуктивності конкретної команди.
- Від постійного нагляду до вибіркового втручання. Anthropic у дослідженні автономії агентів на практиці (18.02.2026) бачить, що досвідчені користувачі дають агентам більше свободи і водночас частіше їх перебивають. Нагляд змінює форму, а не зникає. Автономія там — не мірило якості чи окупності.
- Від згенерованого коду до збереженого розуміння. В експерименті Anthropic про вплив ШІ на навички програмування (29.01.2026) учасники, які працювали з незнайомою бібліотекою за допомогою ШІ, засвоїли менше; ті, хто просив пояснень, зберегли більше розуміння, ніж ті, хто переважно делегував. Це коротка рандомізована задача здебільшого з молодшими розробниками, а не багаторічне спостереження за досвідченими командами, але напрям зрозумілий: важить, як саме ви користуєтесь ШІ.
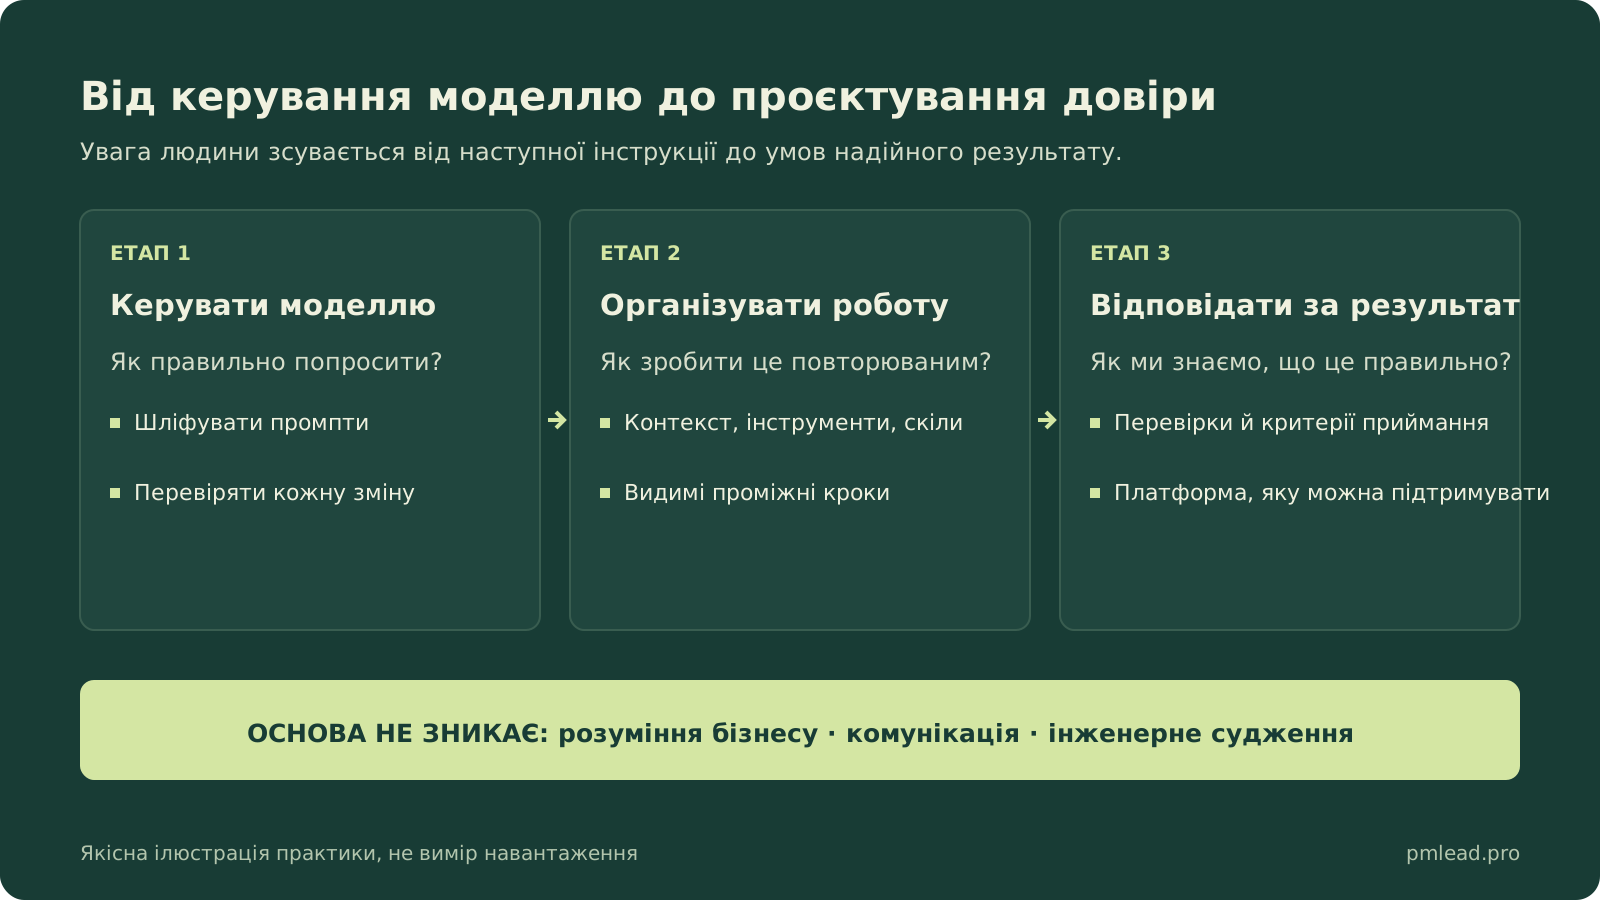
Когнітивне навантаження переміщується, а не зникає
Спершу увага біля моделі: формулювання, перегляд кожної зміни, виправлення помилок. Потім — робоче середовище: контекст, підключені інструменти, процедури, що роблять вдалий прогін повторюваним. Дедалі більше — система навколо результату: критерії приймання, контрольні точки і чи вписується рішення в платформу, яку команда зможе експлуатувати.
Це зміна типу мислення, а не перерозподіл годин. Внести зміну стає легше; побачити й оцінити все, що зробив агент, — часто важче. Опитування працівників знань від Microsoft Research (матеріали CHI ’25, опубліковано 25.04.2025) описує той самий рух до перевірки й нагляду за задачею — на основі самооцінки учасників.
Докази на кожній контрольній точці замість нагляду за кожним кроком
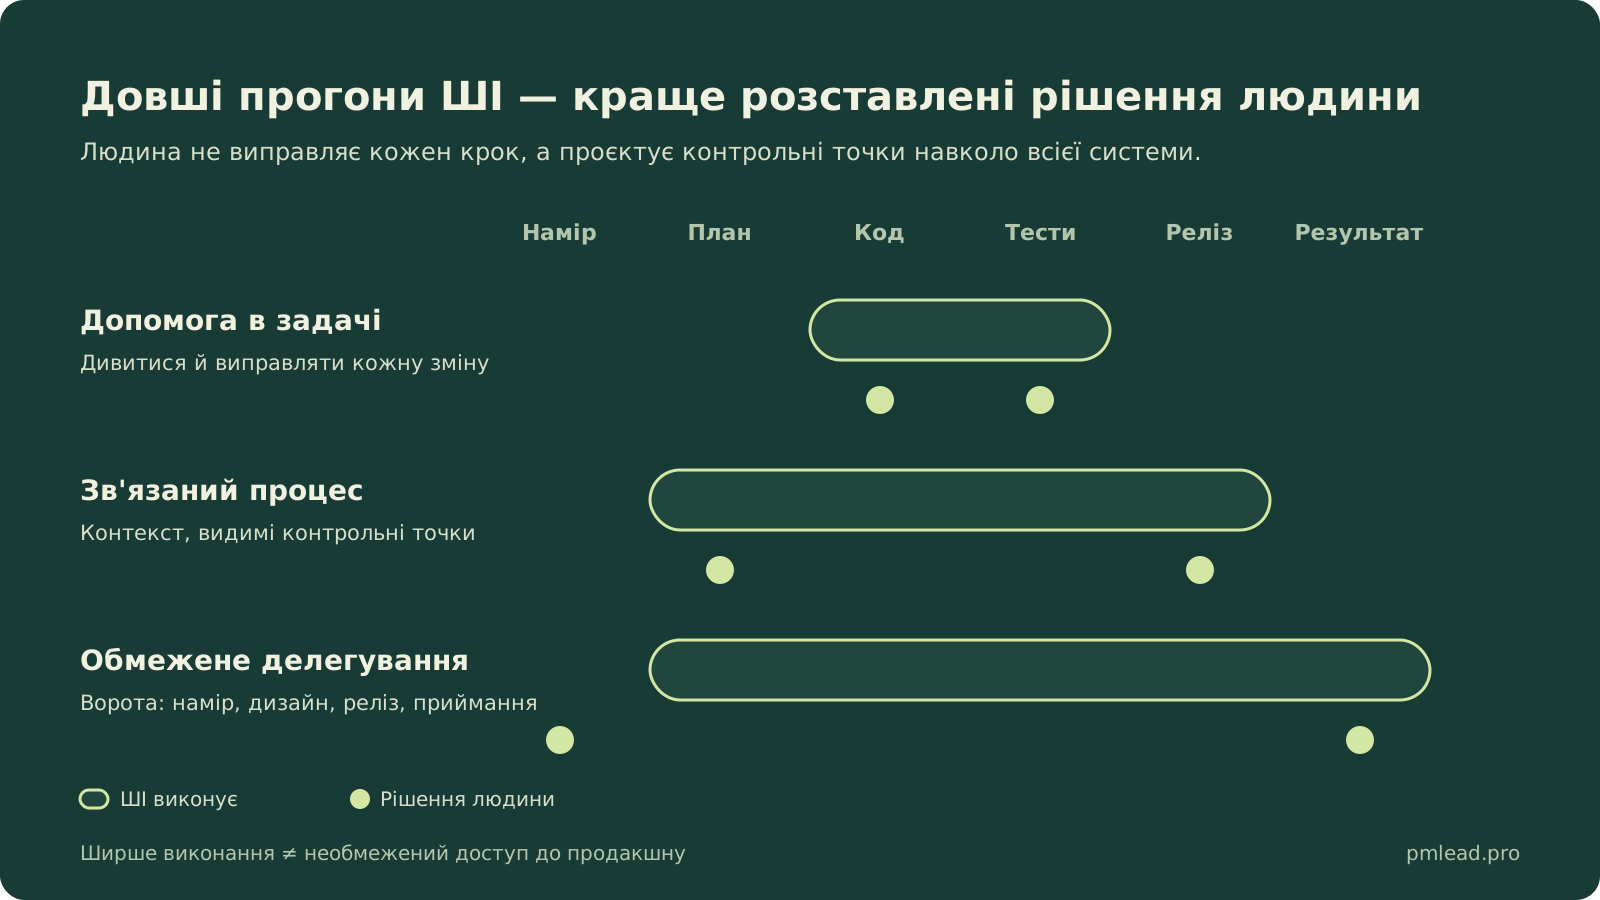
Мета — керований цикл поставки, а не агент із необмеженим доступом до продакшну.
| Контроль | Раніше | Тепер |
|---|---|---|
| Рев’ю | Дивитись зміни файл за файлом | Оцінювати цілісну зміну поведінки разом із доказами |
| Прототипування | Видимі кроки в ноутбуці | Відтворювані докази, хай якими інструментами користувався агент |
| Поставка | Скрипти під окремі задачі | Обмежений CI/CD з тестами, погодженням, моніторингом і відкатом |
| Інфраструктура | Ручне налаштування | Інфраструктура як код після рев’ю і підтримувані шаблони розгортання |
Три пастки, які регулярно трапляються, коли агент автоматизує бізнес-процес. Приклади нижче — ілюстрації, не звіти про конкретні проєкти:
- Збіг за минулий місяць — ще не повнота. Агент переписав розрахунок оплат з Excel у скрипт, і суми за вересень зійшлися з бухгалтерією. Це доводить збіг на вересневих даних. Часткові оплати, повернення чи платежі у валюті там могли просто не трапитись.
- «Тестовий режим» мусить явно вимикати побічні дії. Розсилка рахунків «у тестовому режимі», яка все одно шле клієнтам SMS чи листи, — не тестова. Випишіть, чого прогін торкається, а чого ні, і перевірте це до запуску.
- «Успішно» на вашому боці — не приймання на іншому. Вивантаження товарів на маркетплейс завершилось без помилок, а частину позицій відхилили на модерації наступного дня. Перевіряйте результат там, де його приймають, а не лише статус запуску.
Автономія — це не цінність. Довші прогони без людини не доводять кращого бізнес-результату. Міряйте прийняті результати, дефекти, що дійшли до користувачів, і переробки.
Масштабувати спільну спроможність, а не розрізнені автоматизації
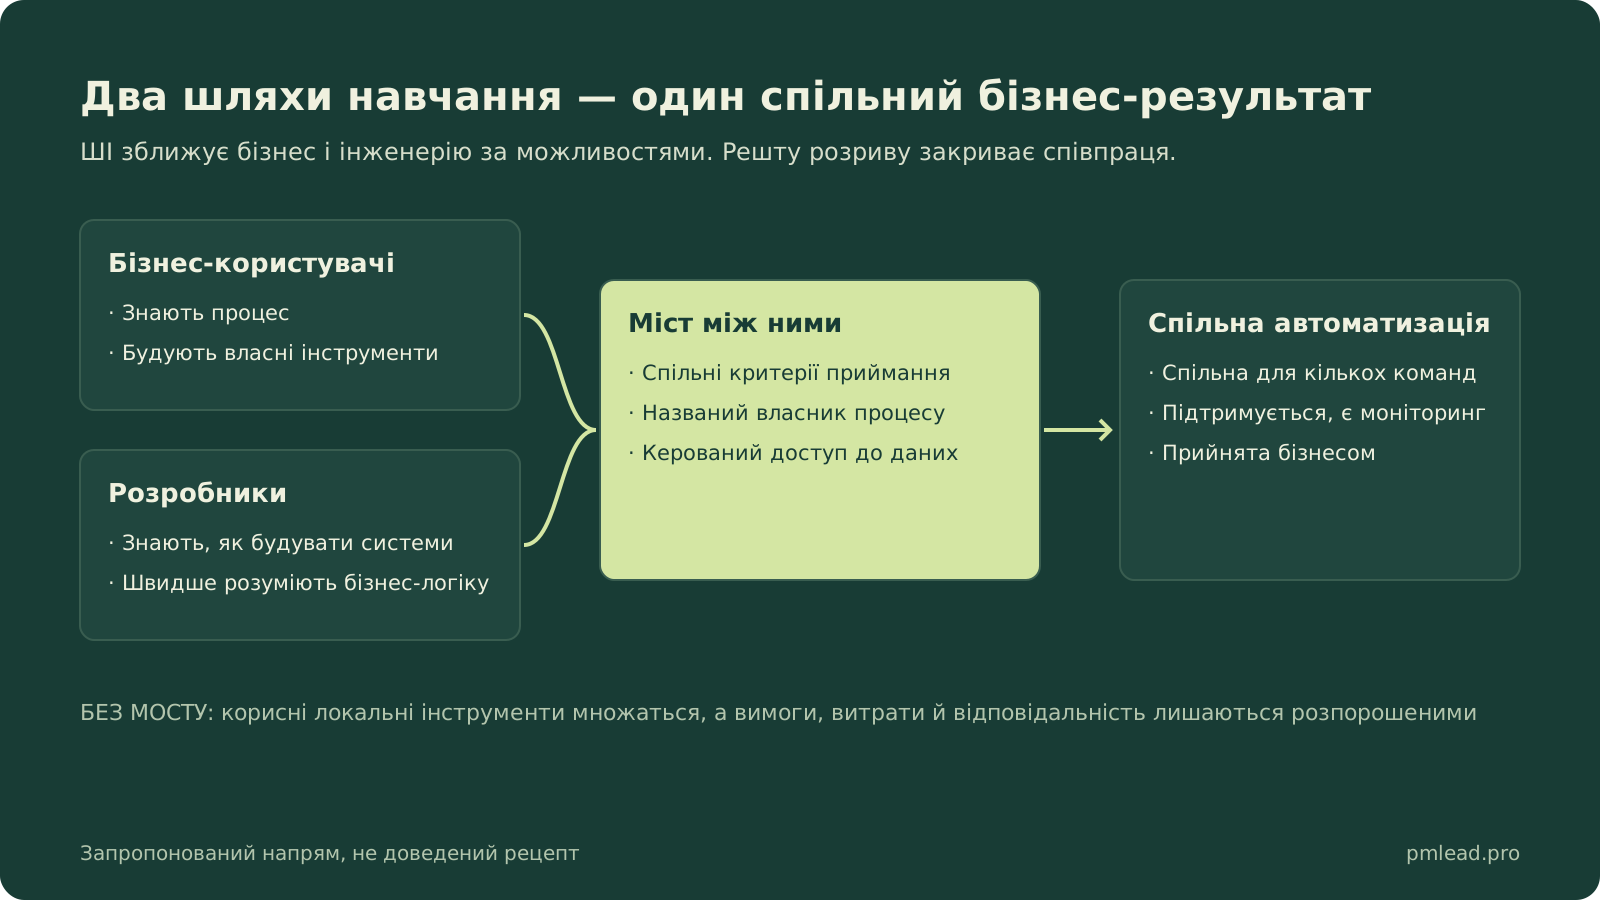
Дослідження підтримують кращу перевірку і свідомий нагляд. Перенесення цього на рівень компанії — наша пропозиція, а не доведений рецепт:
- Підтримувана платформа за замовчуванням і процедура винятків. ШІ здешевлює перенесення коду, але не скасовує перевірки під конкретне середовище, відповідальності за експлуатацію і навчання людей.
- Бізнес у циклі поставки. ШІ пояснить старий код, але не погодить сьогоднішній бізнес-намір. Узгодьте приклади й винятки з бухгалтерією чи операційниками до розробки — і покажіть їм результат.
- Шлях від локального інструмента до спільного сервісу. Реєструйте корисні «особисті» інструменти, призначайте власників, керуйте доступом до даних і рахуйте витрати на використання.
- Прийняті результати, а не згенерована активність. Час до приймання, дефекти, переробки й повна вартість — рев’ю, токени, інфраструктура, повторні перевірки. Кількість pull request чи економія токенів самі по собі нічого не доводять.
Як ми тут працюємо
- Цифра — лише з першоджерелом і датою або з нашим власним заміром з умовами: інструмент, тариф, модель, задача.
- Факт, замір і оцінку позначаємо окремо.
- Виправлення вносимо в сам матеріал.
- Щоденний AI-дайджест — це обговорення джерел дня синтезованими ведучими NotebookLM; ремарки PM Lead Pro пише Claude, озвучує Gemini. Факти належать джерелам — вони на сторінці кожного випуску.
Якщо ви впроваджуєте ШІ в команді й не згодні з чимось тут — саме такої розмови ми й шукаємо.
Джерела: Microsoft Research — SkillOpt: agent skills as trainable parameters (30.06.2026) · Anthropic — Measuring AI agent autonomy in practice (18.02.2026) · Anthropic — How AI assistance impacts the formation of coding skills (29.01.2026) · Microsoft Research — The impact of generative AI on critical thinking (CHI ’25, опубліковано 25.04.2025) · Anthropic — Effective context engineering for AI agents (29.09.2025)